KI in der Softwareentwicklung: Warum Agenturgröße kein Argument mehr ist
KI hat den Engpass in der Softwareentwicklung verschoben — vom Schreiben zum Beurteilen. Warum damit die Mitarbeiterzahl einer Agentur nichts mehr über Projekttempo sagt und welche Entscheidungen stattdessen zählen.

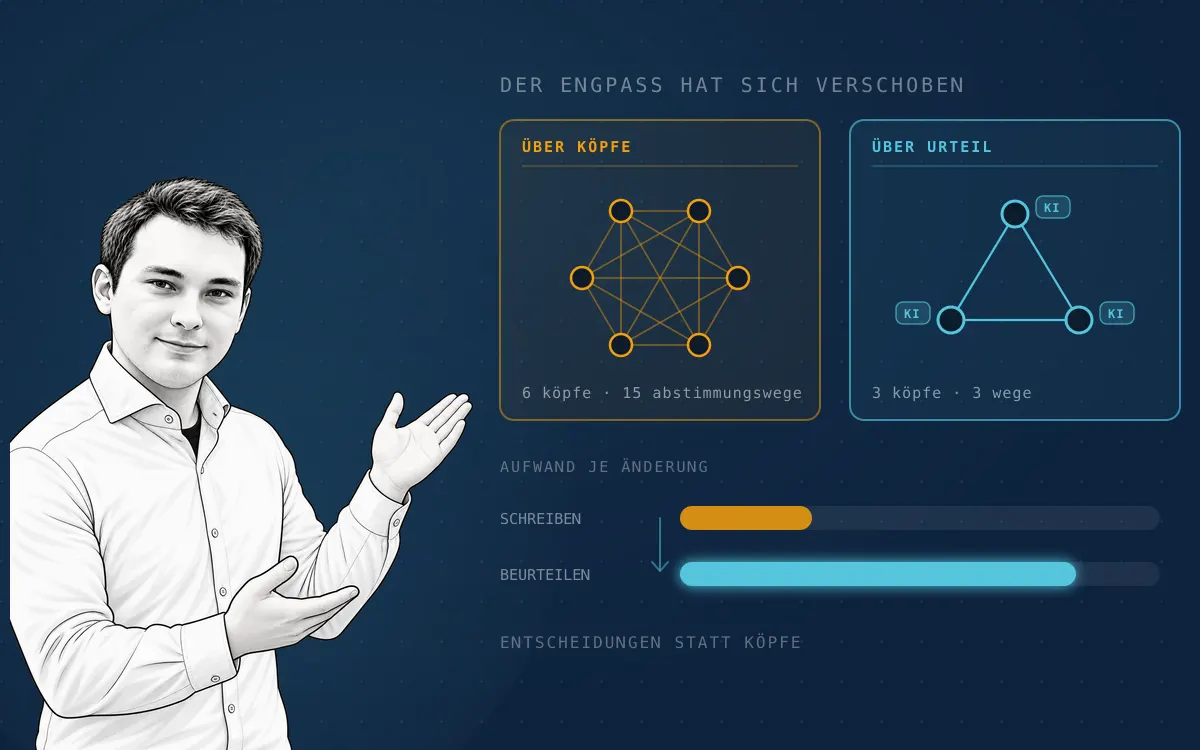
Es gibt einen Satz, der in Agentur-Pitches seit zwanzig Jahren funktioniert: „Wir haben 120 Mitarbeiter.“ Gemeint ist damit nie die Zahl selbst, gemeint ist ein Versprechen — Ausfallsicherheit, Tempo, Skalierbarkeit. Wenn einer krank wird, übernimmt der nächste. Wenn es eng wird, setzen wir zwei Leute mehr drauf.
Dieses Versprechen kam aus einer Welt, in der Output ziemlich direkt an Personenstunden hing. Wer doppelt so viel liefern wollte, brauchte etwa doppelt so viele Hände. In dieser Welt war Größe tatsächlich ein Argument.
Diese Welt gibt es nicht mehr — jedenfalls nicht an der Stelle, an der sie früher den Unterschied machte. KI hat am Tempo der Softwareentwicklung weniger geändert, als die Marketingfolien behaupten, und mehr, als die Skeptiker zugeben. Vor allem aber hat sie den Engpass verschoben: weg vom Schreiben des Codes, hin zum Beurteilen des Codes. Und diese Verschiebung trifft große und kleine Dienstleister völlig unterschiedlich.
Was die Daten sagen — und was nicht
Fangen wir mit der unbequemen Zahl an. METR hat 2025 einen randomisierten Versuch mit 16 erfahrenen Open-Source-Entwicklern über 246 echte Aufgaben in ihren eigenen, ihnen vertrauten Repositories gefahren. Erwartet wurde ein Tempogewinn von 24 Prozent. Gemessen wurde das Gegenteil: Mit KI-Werkzeugen brauchten die Entwickler 19 Prozent länger. Noch bemerkenswerter ist die Selbsteinschätzung danach — die Teilnehmer glaubten, 20 Prozent schneller gewesen zu sein (METR).
Diese Lücke zwischen Gefühl und Messung ist der wichtigste Befund der letzten zwei Jahre. Sie erklärt, warum fast jeder Entwickler von massiven Produktivitätsgewinnen berichtet, während die Projektlaufzeiten in vielen Unternehmen unverändert sind. KI fühlt sich schnell an, weil die Phase des Starrens auf eine leere Datei verschwindet. Was dahinter liegt — lesen, prüfen, verwerfen, nachjustieren — fühlt sich nicht nach Arbeit an der Aufgabe an, ist es aber.
Zwölf Monate später sieht es anders aus
Wer diese 19 Prozent heute als Beweis gegen KI zitiert, zitiert veraltete Daten — METR selbst weist die Studie inzwischen als überholt aus. Im Februar 2026 hat das Team eine Fortsetzung mit 57 Entwicklern, 143 Repositories und über 800 Aufgaben veröffentlicht. Für die zehn Entwickler, die auch in der ersten Runde dabei waren, kippt das Vorzeichen: geschätzt 18 Prozent schneller, bei einem Konfidenzintervall von 38 Prozent schneller bis 9 Prozent langsamer. Bei den neu rekrutierten Teilnehmern bleibt der Effekt mit 4 Prozent im Rauschen (METR, Februar 2026).
Dazu gehört die Einschränkung, die METR selbst betont: Die Studie leidet inzwischen an Selektion. Entwickler lehnen die Teilnahme ab, weil sie nicht ohne KI arbeiten wollen, und 30 bis 50 Prozent gaben an, Aufgaben bewusst nicht eingereicht zu haben — genau die Aufgaben, bei denen KI den größten Hebel gehabt hätte. Der tatsächliche Effekt könnte also höher liegen als der gemessene.
Zwei Dinge sind trotzdem belastbar. Erstens: Die Werkzeuge sind innerhalb von zwölf Monaten von „bremst erfahrene Entwickler aus“ auf „hilft denen, die sie beherrschen“ gesprungen. Zweitens: Der Gewinn hängt an der Person, nicht am Werkzeug. Dieselben Modelle, dieselben Aufgaben — und der Unterschied zwischen Rückschritt und Fortschritt lag darin, wer sie bedient und wie lange er darin geübt ist.
Die Verifikationssteuer
Die DORA-Forschung von Google Cloud liefert dazu das Bild aus der Breite: 90 Prozent der Technologie-Fachkräfte nutzen KI bei der Arbeit, über 80 Prozent sind überzeugt, dadurch produktiver zu sein. Gleichzeitig steigt mit der KI-Nutzung nicht nur der Durchsatz, sondern auch die Instabilität der Auslieferung (DORA). Mehr Änderungen pro Woche, mehr davon gehen schief.
DORA nennt den Mechanismus dahinter die Verifikationssteuer: Die Zeit, die beim Schreiben gespart wird, wandert ins Prüfen. Review wird vom Qualitätsritual zum Nadelöhr, und die kognitive Last verschiebt sich von dem, der produziert, auf den, der gegenliest. Wer kein belastbares Prüfsystem hat, zahlt diese Steuer nicht in Zeit, sondern in Produktionsfehlern.
Der Stack Overflow Developer Survey 2026 zeigt, dass die Entwickler selbst genau so arbeiten: 48 Prozent vertrauen KI-Ergebnissen nur dann, wenn sie sie leicht überprüfen können. Ganze 6,6 Prozent würden ihnen bei wichtigen Entscheidungen vertrauen (Stack Overflow 2026). Das ist keine Technikskepsis, das ist eine Arbeitsweise: generieren lassen, dann selbst entscheiden.
KI ist ein Verstärker, kein Gleichmacher
Der Satz, der aus der DORA-Arbeit hängen bleiben sollte, lautet: KI ist in der Softwareentwicklung vor allem ein Verstärker. Sie vergrößert die Stärken leistungsfähiger Organisationen und die Dysfunktionen der strauchelnden.
Das ist das Gegenteil dessen, was viele erwartet haben. Die Erwartung war Nivellierung — wenn das Modell den Code schreibt, spielt es keine Rolle mehr, wer davor sitzt. Tatsächlich passiert das Umgekehrte. Wo eine saubere Architektur, klare Schnittstellen, echte Testabdeckung und ein funktionierendes Review vorhanden sind, wird aus dem Verstärker Tempo. Wo sie fehlen, wird daraus technische Schuld — in derselben Geschwindigkeit.
Und hier beginnt das eigentliche Thema dieses Beitrags: Nichts von dem, was den Verstärker nutzbar macht, ist eine Funktion der Mitarbeiterzahl. Eine saubere Domänenmodellierung entsteht nicht dadurch, dass mehr Leute daran arbeiten. Eine gute Stack-Entscheidung wird nicht besser, wenn sie von einem Gremium getroffen wird. Testabdeckung ist eine Frage der Disziplin, nicht der Kapazität.
Warum Headcount noch nie Tempo war
Fred Brooks hat 1975 im Mythical Man-Month beschrieben, warum zusätzliche Entwickler ein verspätetes Projekt noch weiter verspäten: Der Kommunikationsaufwand wächst nicht linear mit der Teamgröße, sondern quadratisch. Sechs Leute haben 15 mögliche Abstimmungspaare, zwanzig Leute haben 190. Jede dieser Verbindungen ist eine Stelle, an der Kontext verloren geht.
In Agenturen kommt eine zweite Schicht dazu, die mit Kommunikation nichts zu tun hat, sondern mit Geschäftsmodell. Je größer die Organisation, desto wahrscheinlicher ist, dass der, der das Projekt verkauft, nicht der ist, der es baut. Dazwischen liegen Übergaben: vom Vertrieb in die Beratung, von der Beratung in die Konzeption, von der Konzeption in die Entwicklung. Bei jeder Übergabe wird ein Dokument geschrieben statt eine Entscheidung getroffen.
Diese Übergabekosten waren immer da. Früher wurden sie dadurch aufgewogen, dass auf der anderen Seite tatsächlich Kapazität stand: Zehn Entwickler schrieben in einer Woche nun einmal mehr Zeilen als zwei. Genau dieser Ausgleich fällt weg. Die Hebelwirkung der reinen Schreibkapazität ist gesunken, die Übergabekosten sind geblieben. Was übrig bleibt, ist ein Strukturnachteil.
Das ist kein Argument gegen große Dienstleister an sich. Für Multi-Länder-Rollouts mit parallelen Teams, 24/7-Betriebsmodellen oder Projekten, in denen zehn Fachdisziplinen gleichzeitig arbeiten müssen, ist Größe weiterhin die richtige Antwort. Es ist ein Argument dagegen, Mitarbeiterzahl als Qualitäts- oder Tempoversprechen zu lesen. Für das typische Commerce-Projekt — ein Shop, ein ERP, ein paar Schnittstellen, klare Prozesse — sagt sie nichts mehr aus.
Die vier Entscheidungen, die heute den Unterschied machen
Wenn Schreibkapazität nicht mehr der Engpass ist, dann liegt der Engpass bei den Entscheidungen. Und zwar bei vier davon. Jede einzelne wird von einer erfahrenen Person in Stunden getroffen oder von einer unerfahrenen in Wochen verfehlt — und beide Varianten sind von außen zunächst nicht zu unterscheiden, weil in beiden Fällen Code entsteht, der funktioniert.
1. Standard oder eigener Code
KI hat die Kosten für die erste Version von Eigenentwicklung dramatisch gesenkt. Das ist die gefährlichste Veränderung von allen, denn sie verschiebt die Build-or-Buy-Abwägung scheinbar zugunsten von „build“. Scheinbar — weil generierter Code ein Vermögenswert mit Unterhaltskosten ist. Er muss gelesen, aktualisiert, migriert und bei jedem Major-Update des umgebenden Systems nachgezogen werden.
Konkret in Shopware: Wenn eine Anforderung über die offiziellen Erweiterungspunkte lösbar ist, ist sie dort update-sicher gelöst. Wenn ein Modell in zwanzig Minuten eine funktionierende Core-Anpassung erzeugt, ist die Anforderung heute erfüllt und beim nächsten Major-Release ein Problem. Shopware selbst nennt in seinem Plugin-Leitfaden genau die Eigenschaften, die später den Unterschied machen — idempotente Migrationen, minimale Lifecycle-Logik, gekapselte Domänenlogik (Shopware Developer Docs). Diese Unterscheidung treffen zu können, ist Erfahrung. Das Modell trifft sie nicht, es setzt um, was man ihm sagt.
2. Wo die Logik liegt
Preislogik im Theme oder im Domain-Code. Rabattregeln im ERP oder im Shop. Katalogtransformation in der Pipeline oder im Frontend. Diese Entscheidungen bestimmen, ob ein System in zwei Jahren erweiterbar ist oder ob jede Änderung drei Stellen betrifft.
Hier wirkt der Verstärker am deutlichsten. Ein KI-Agent, der auf einen sauberen Domänenschnitt losgelassen wird, liefert erstaunlich konsistente Ergebnisse, weil die Struktur den Lösungsraum vorgibt. Derselbe Agent in einem System ohne klare Grenzen produziert plausiblen Code an der jeweils falschen Stelle — und zwar sehr viel davon, sehr schnell.
3. Das Prüfsystem
Wenn die Verifikationssteuer real ist, dann ist das Prüfsystem der eigentliche Produktivitätsfaktor. Dazu gehören automatisierte Tests, die Verhalten absichern statt Implementierung, eine CI, die bei rot wirklich blockiert, Staging-Umgebungen, die der Produktion entsprechen, Monitoring ab Tag eins — und ein menschliches Review, das nicht durchwinkt.
Das ist die Stelle, an der die meisten KI-Erwartungen scheitern. Ein Team, das dreifach so viele Änderungen produziert und dasselbe Review-Nadelöhr behält, hat keinen Durchsatz gewonnen, sondern eine Warteschlange gebaut. Deshalb gehört zu jeder Diskussion über KI-Tempo die Frage, wer gegenliest und mit welchem Maßstab. Wie wir das organisieren, steht in Entwicklung; wie der Betrieb danach aussieht, in Wartung und Weiterentwicklung.
4. Was nicht gebaut wird
Die wirkungsvollste Entscheidung ist weiterhin die Streichung. Je billiger die Umsetzung wird, desto schwächer wird die natürliche Bremse, die Aufwand früher eingebaut hat. Features, die früher am Budget gescheitert sind, werden jetzt gebaut — und jedes davon ist dauerhaft zu pflegen.
Eine Agentur, die hier Nein sagt, spart mehr Geld als jede Effizienzsteigerung in der Umsetzung. Das setzt allerdings voraus, dass ihr Geschäftsmodell nicht daran hängt, Stunden auszulasten. Wer Kapazität vorhalten muss, hat ein strukturelles Interesse daran, sie zu füllen.
Das neue Risikoprofil
KI hat Projektrisiko nicht reduziert, sondern verlagert. Vier Risiken sind heute größer als vor zwei Jahren:
Plausibler Code, der nicht hält. Generierter Code sieht fast immer richtig aus. Er benennt Variablen sinnvoll, hat eine Struktur und erzeugt keine Syntaxfehler. Die Fehler liegen in Randfällen, Nebenwirkungen und Annahmen — genau dort, wo Code-Review oberflächlich nicht hinschaut.
Beschleunigte technische Schuld. Die DORA-Daten zeigen den Zusammenhang zwischen KI-Nutzung und Auslieferungs-Instabilität. Ein System, das in sechs Monaten doppelt so viel Code bekommt wie geplant, ist nicht doppelt so weit, sondern doppelt so schwer zu durchschauen.
Verlust der Übergabefähigkeit. Code, den niemand im Team erklären kann, ist kein Vermögenswert, sondern eine Abhängigkeit. Die Frage „Kann ein anderes Team das übernehmen?“ ist die ehrlichste Qualitätsprüfung — und sie wird mit generiertem Code wichtiger, nicht unwichtiger.
Sicherheit. Mehr Code, schnellere Zyklen und Abhängigkeiten, die nebenbei hinzugefügt werden, vergrößern die Angriffsfläche. Wie schnell daraus ein akuter Vorfall wird, haben wir bei der PHP-Sicherheitslücke PHP2Shell beschrieben.
Keines dieser Risiken skaliert mit der Agenturgröße nach unten. Zwei von ihnen — technische Schuld und Übergabefähigkeit — werden in großen Teams sogar strukturell wahrscheinlicher, weil niemand das Gesamtsystem im Kopf hat.
Häufige Fragen zu KI in der Softwareentwicklung und zur Wahl des Dienstleisters.
Macht KI kleine Agenturen leistungsfähiger als große? +
Nicht automatisch. KI wirkt laut DORA-Forschung als Verstärker bestehender Bedingungen — sie vergrößert die Stärken leistungsfähiger Teams und die Dysfunktionen schwacher. Kleine Teams profitieren dort, wo kurze Entscheidungswege und Senior-Besetzung zusammenkommen, weil der Engpass vom Schreiben zum Beurteilen gewandert ist. Ein kleines Team ohne Prüfsystem ist dadurch nicht besser, nur schneller beim Aufbau technischer Schuld.
Wie viel schneller ist Entwicklung mit KI wirklich? +
Belastbar ist vor allem die Spannweite. Ein randomisierter Versuch von METR fand für erfahrene Entwickler mit Werkzeugen von Anfang 2025 eine Verlangsamung um 19 Prozent; dieselben Entwickler lagen mit Werkzeugen von Ende 2025 geschätzt 18 Prozent schneller, bei weitem Konfidenzintervall. In der Breite berichten über 80 Prozent der Fachkräfte von höherer Produktivität, während gleichzeitig die Instabilität der Auslieferung steigt. Der Gewinn hängt also an Übung, Aufgabentyp und Prüfsystem, nicht am Werkzeug allein.
Warum zählt die Mitarbeiterzahl einer Agentur weniger als früher? +
Weil Schreibkapazität nicht mehr der Engpass ist. Der Koordinationsaufwand wächst quadratisch mit der Teamgröße, und in größeren Organisationen liegen zwischen Verkauf und Umsetzung mehrere Übergaben. Früher wurde dieser Aufwand durch echte Kapazität ausgeglichen; da der Hebel reiner Umsetzungsstunden gesunken ist, bleibt der Koordinationsaufwand ohne Gegenwert. Für parallele Multi-Länder-Rollouts oder 24/7-Betrieb bleibt Größe trotzdem die richtige Antwort.
Woran erkenne ich, ob eine Agentur KI verantwortlich einsetzt? +
{ "An ihrem Prüfsystem, nicht an ihren Werkzeugen": { " Belastbare Fragen": "Wer liest generierten Code gegen und mit welchem Maßstab? Blockiert die CI bei rot? Gibt es Tests, die Verhalten statt Implementierung absichern? Entsteht Dokumentation, mit der ein anderes Team übernehmen könnte? Und kann die Agentur erklären, warum eine Anforderung über Standard-Erweiterungspunkte statt über eigenen Code gelöst wurde?" } }
Wird Softwareentwicklung durch KI billiger? +
Selten in der Rechnung, oft in der Wirkung. Was günstiger wird, ist die erste funktionierende Version. Was bleibt, sind Prüfung, Betrieb, Updates und Pflege jeder gebauten Funktion. Der tatsächliche Gewinn zeigt sich meist nicht als niedrigerer Angebotspreis, sondern als mehr Iterationen im gleichen Budget — und als die Möglichkeit, Dinge zu verwerfen, bevor sie teuer werden.
Wie du eine Agentur heute bewertest
Die Mitarbeiterzahl steht in jedem Pitch-Deck, weil sie leicht zu nennen ist. Diese acht Fragen sind schwerer zu beantworten und sagen deutlich mehr aus:
- Wer baut, mit dem ich spreche? Wenn die Antwort eine Rolle enthält, die nicht im Code arbeitet, gibt es eine Übergabe — und damit die erste Stelle, an der Kontext verloren geht.
- Welche Entscheidung würdet ihr in unserem Projekt gegen den Standard treffen und warum? Eine Agentur, die auf diese Frage keine konkrete Abwägung liefert, hat sie noch nicht geführt.
- Wer liest generierten Code gegen? Und in welchem Verhältnis steht das zur produzierten Menge? Review ist der limitierende Faktor, nicht die Generierung.
- Was ist in euren Projekten getestet — Verhalten oder Implementierung? Tests gegen Implementierung brechen bei jedem Refactoring und werden deshalb abgeschaltet.
- Blockiert eure CI? Ein Pipeline-Status, der rot sein darf, ist Dekoration.
- Wie lange dauert bei euch eine Architekturentscheidung? Stunden ist eine Antwort, „das klären wir intern“ ist eine Organisationsbeschreibung.
- Was würdet ihr in unserer Anforderungsliste streichen? Wer nichts streicht, verkauft Umsetzung statt Ergebnis.
- Könnte ein anderes Team das System in sechs Monaten übernehmen? Und woran würde man das vor der Beauftragung erkennen — Dokumentation, Tests, Architekturbeschreibung?
Keine dieser Fragen hat mit Größe zu tun. Alle acht lassen sich von einem Zweipersonen-Team genauso gut beantworten wie von einer Agentur mit 120 Köpfen — und in unserer Erfahrung häufig besser, weil die Antwort nicht erst intern eingeholt werden muss.
Was das für Budget und Zeitplan bedeutet
Drei Dinge, die sich in Projekten tatsächlich verändert haben:
Prototypen sind fast kostenlos geworden. Eine strittige Frage — Konfigurator ja oder nein, dieser Checkout-Fluss oder jener — lässt sich heute in Tagen als funktionierendes Stück Software beantworten statt in Wochen als Konzeptpapier. Das verschiebt Entscheidungen von Meinung auf Evidenz. Genau dafür sind die Zahlen aus einer messbaren Strategie die Grundlage: Ohne definierte Kennzahl ist der Prototyp nur eine neue Meinung.
Die Stack-Entscheidung wiegt mehr als früher. Wenn Umsetzung schnell geht, wird die Wahl der Plattform zum dominierenden Kostenfaktor über die Laufzeit. Lizenzmodell, Gebührenstruktur, Erweiterbarkeit und Update-Pfad entscheiden über Jahre — und sind kaum zu korrigieren. Diese Abwägung haben wir für zwei Plattformen im Detail durchgerechnet: Shopware oder Shopify.
Der Ergebnisanteil am Budget steigt. Wenn weniger Budget in Umsetzung fließt, kann mehr in Analyse, Messung und Iteration fließen — oder es wird in zusätzliche Features gesteckt. Das ist eine Entscheidung, keine Konsequenz. Sie fällt in der Priorisierung, und genau dort liegt der Unterschied zwischen einem Projekt, das liefert, und einem, das viel enthält.
Was sich nicht verändert hat: Ein Projekt wird nicht halb so teuer, weil die Modelle besser geworden sind. Der Aufwand verschiebt sich von der Produktion in die Beurteilung — und Beurteilung ist Senior-Arbeit.
Wie wir das halten
Wir sind zwei Gründer, und das ist bei uns keine Wachstumsphase, sondern eine Entscheidung: Output pro Kopf statt Köpfe pro Projekt. Wer berät, baut auch. Zwischen dem Gespräch und dem Code liegt keine Übergabe, und Architekturentscheidungen fallen in Stunden statt in Freigabeketten.
Diese Struktur war vor fünf Jahren ein Kapazitätsrisiko. Mit KI-Werkzeugen, die den Umsetzungsanteil verdichten, wird daraus ein Vorteil — aber nur zusammen mit dem Teil, der Arbeit bleibt: Tests, die Verhalten absichern, CI, die blockiert, Monitoring ab Tag eins, Dokumentation, mit der ein anderes Team übernehmen könnte. Wir setzen KI täglich ein, und zwar an der Stelle, an der sie trägt: Umsetzung beschleunigen, nicht Entscheidungen ersetzen. Welche Entscheidung getroffen wird, verantwortet eine Person mit Namen.
Wie das methodisch zusammenhängt, steht in F.O.C.U.S. — Facts vor Objectives, Constraints vor Execution. Die Reihenfolge ist mit KI wichtiger geworden, nicht beliebiger: Wer schneller bauen kann, kann auch schneller das Falsche bauen.
Der nächste Schritt
Drei Prüfungen, für die du keinen Pitch brauchst:
- Frage bei deinem aktuellen Dienstleister nach, wer generierten Code gegenliest. Die Antwort sagt dir mehr über dein Risiko als jede Referenzliste.
- Nimm die letzten drei abgelehnten Features und rechne sie neu. Wenn Umsetzung heute einen Bruchteil kostet, ändert das die Priorisierung — oder es zeigt, dass sie aus guten Gründen abgelehnt wurden.
- Prüfe, ob dein System übergabefähig ist. Nicht, weil du wechseln willst, sondern weil die Antwort der beste Indikator für seinen Zustand ist.
Wenn du die Stack- und Umsetzungsentscheidungen nicht allein treffen willst: Genau das machen wir in der Beratung, und in Entwicklung setzen wir sie um. Melde dich — ein Gespräch mit denen, die es auch bauen.
Quellen und weiterführende Informationen
- DORA (Google Cloud): Balancing AI tensions — Moving from AI adoption to effective SDLC use
- DORA: State of AI-assisted Software Development 2025 (PDF)
- DORA: ROI of AI-assisted Software Development
- METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
- METR: We are Changing our Developer Productivity Experiment Design (Februar 2026)
- Stack Overflow Developer Survey 2026: Trust in AI tools
- Shopware Developer Docs: Plugin Base Guide
Weiterlesen
Reden wir über dein System.
Kein Pitch-Deck. Ein Gespräch mit denen, die auch bauen.